Un sitemap XML per un sito di giardinaggio non si limita a un file tecnico generato automaticamente da un CMS. Il modo in cui questo file è strutturato determina il modo in cui i motori di ricerca scoprono e gerarchizzano i contenuti, dalle schede delle piante alle guide stagionali. Per un sito che pubblica contenuti vari (articoli, schede di coltivazione, video, pagine prodotto), la segmentazione del sitemap diventa un leva concreta di ottimizzazione del posizionamento.
Segmentare il sitemap per tipo di contenuto su un sito di giardinaggio
La maggior parte dei siti genera un sitemap unico che mescola tutti gli URL in un solo file. Per un sito di giardinaggio, questo approccio nasconde i problemi di esplorazione. Se le schede delle piante sono meno indicizzate rispetto agli articoli del blog, un sitemap monolitico non consente di individuarlo.
Una struttura più efficace si basa su un sitemap index che punta verso diversi sitemap specializzati. Ogni sotto-file raggruppa un tipo di contenuto specifico:
- Un sitemap dedicato alle schede delle piante (varietà, arbusti, perenni), che costituiscono spesso il cuore del collegamento interno di un sito di giardinaggio.
- Un sitemap per le guide stagionali e articoli editoriali, il cui ritmo di pubblicazione segue il calendario delle semine, piantagioni e raccolti.
- Un sitemap separato per le pagine di categorie (orto, ornamentali, fruttiferi), che servono da pagine pilastro per il posizionamento.
- Sitemaps specializzati per le immagini e i video, particolarmente utili quando il sito offre tutorial visivi di potatura, talea o manutenzione.
Questa segmentazione facilita l’analisi in Google Search Console. Quando un problema di indicizzazione colpisce un tipo di pagina, appare nel rapporto del sitemap corrispondente, senza inquinamento da parte degli altri contenuti. Si può osservare, ad esempio, che la pagina sitemap di Une Fleur Un Jardin illustra questa logica di suddivisione per famiglie di contenuti.
Tag lastmod e schede di coltivazione: quando la data conta davvero
Il tag lastmod deve riflettere un aggiornamento editoriale reale, non una semplice rigenerazione automatica del file. Google indica che può sfruttare questo dato quando è coerente e verificabile. Sostituire sistematicamente la data con quella del giorno svuota questa informazione di ogni valore.
Su un sito di giardinaggio, i casi di aggiornamento legittimo sono concreti. Una scheda di coltivazione merita una nuova data lastmod quando il periodo di semina viene corretto, quando una resistenza al gelo viene rivista, quando un metodo di trattamento viene modificato o quando vengono aggiunti dati strutturati.
D’altra parte, correggere un errore di battitura o cambiare un’immagine decorativa non giustifica di segnalare una modifica ai motori di ricerca. Una data lastmod affidabile aiuta i robot a dare priorità al recrawl delle pagine realmente modificate, il che ha tutto il senso su un sito le cui schede delle piante si contano a centinaia.
Frequenza di aggiornamento e stagionalità
I contenuti di giardinaggio seguono un ciclo naturale. Le guide di semina, ad esempio, sono pertinenti in primavera e dovrebbero idealmente essere aggiornate ogni anno con le nuove varietà o gli aggiustamenti legati al clima. Un sitemap ben gestito consente ai motori di individuare questi aggiornamenti stagionali e di recrawlare le pagine al momento giusto.
Le pagine di categorie, invece, cambiano meno frequentemente. Il loro lastmod dovrebbe evolvere solo quando una ristrutturazione modifica le sottocategorie o il collegamento interno associato.
Errori frequenti nella struttura di un sitemap per il SEO
Numerosi errori ricorrenti compromettono l’utilità di un sitemap, particolarmente sui siti di giardinaggio che accumulano contenuti nel corso delle stagioni.
Includere URL con errore 404 o reindirizzamenti 301 nel sitemap invia un segnale contraddittorio ai motori. Il file deve elencare solo gli URL che restituiscono un codice 200. Su un sito di giardinaggio che rimuove regolarmente schede di piante ritirate dal catalogo, è necessaria una pulizia periodica del sitemap.
Un altro tranello: elencare pagine a basso valore SEO. Le pagine di tag generate automaticamente (ad esempio “tag: irrigazione”, “tag: estate”), le pagine di risultati di ricerca interne o le pagine di paginazione non apportano nulla in un sitemap. Diluiscono il budget di crawl senza migliorare l’indicizzazione dei contenuti strategici.
Dimensione del file e limite tecnico
Un sitemap XML non può superare una certa dimensione. Per un sito di giardinaggio di dimensioni modeste, questo limite di solito non è un problema. Tuttavia, i siti che combinano un catalogo di piante, un blog fornito e pagine e-commerce possono avvicinarsi a questo limite. Il sitemap index risolve questo problema distribuendo gli URL su più file.
Sitemap e collegamento interno: due logiche complementari per un sito di giardinaggio
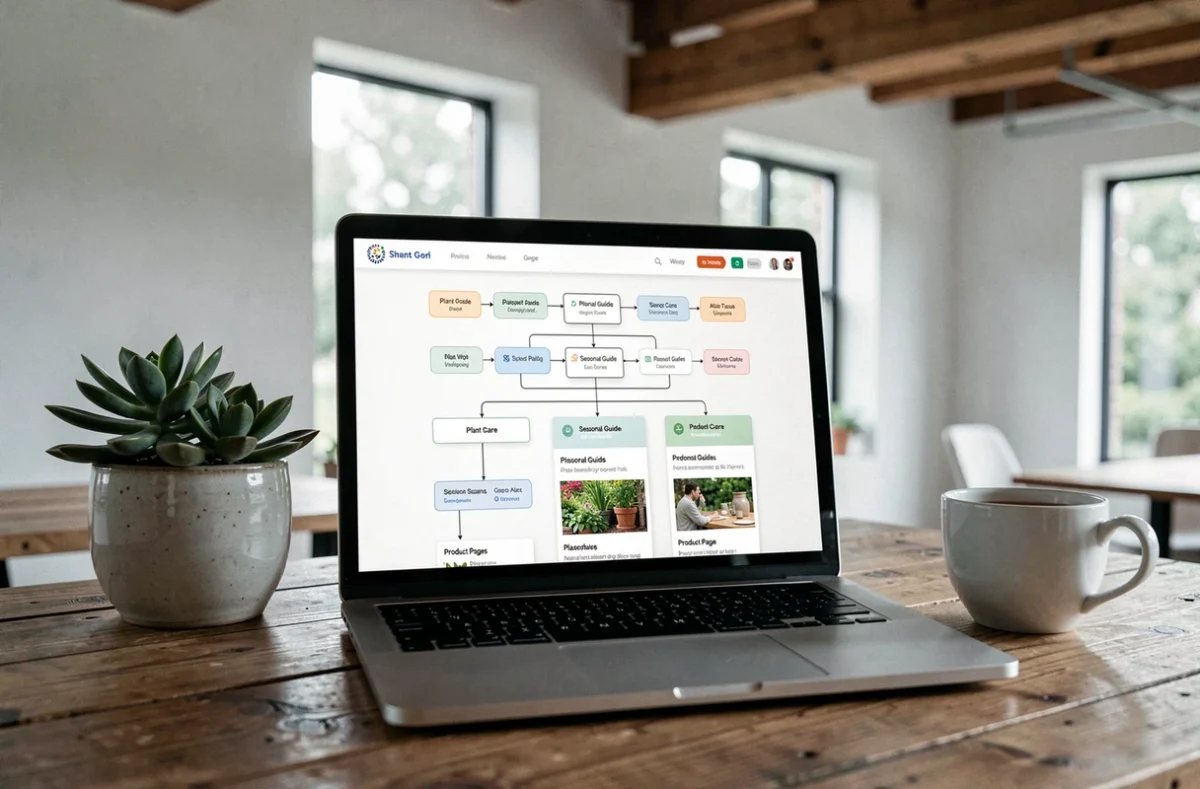
Il sitemap non sostituisce un collegamento interno coerente. Google lo ricorda: un sitemap completa la scoperta tramite i link, non lo sostituisce. Su un sito di giardinaggio, il collegamento collega naturalmente le schede delle piante alle guide stagionali, le categorie alle sottocategorie, i tutorial video alle schede tecniche corrispondenti.
Il sitemap interviene per le pagine orfane o i contenuti recentemente pubblicati che non hanno ancora ricevuto link interni. Una nuova scheda su una varietà di pomodoro antico, ad esempio, può impiegare diverse settimane per essere scoperta dai robot se non c’è alcun link che punti verso di essa. Il sitemap accelera questa scoperta.
I feedback sul campo divergono sull’impatto reale del sitemap per i piccoli siti ben collegati. Su un sito di alcune decine di pagine con una navigazione chiara, il beneficio rimane marginale. Su un sito che supera diverse centinaia di schede di coltivazione, guide e pagine prodotto, la segmentazione del sitemap diventa uno strumento di gestione del posizionamento piuttosto che una semplice formalità tecnica.
Dichiarare il sitemap nel file robots.txt e nella Search Console rimane l’ultimo passo. Senza questa dichiarazione, il file esiste ma i motori non sanno dove trovarlo, il che annulla tutto il lavoro di strutturazione effettuato in precedenza.